8月20日,一款神秘的前沿多模态推理模型OX Alpha在OpenRouter 上匿名上线,其强大的能力被网友称为牛来模型,26日,智谱确认是其 GLM 系列新版本(GLM‑5.3‑Flash 的匿名测试形态)。这款模型最值得关注的地方,并不是简单地“又发布了一个 GLM”,而是它试图同时解决三个问题:
前沿能力、原生多模态,以及极低的调用成本。
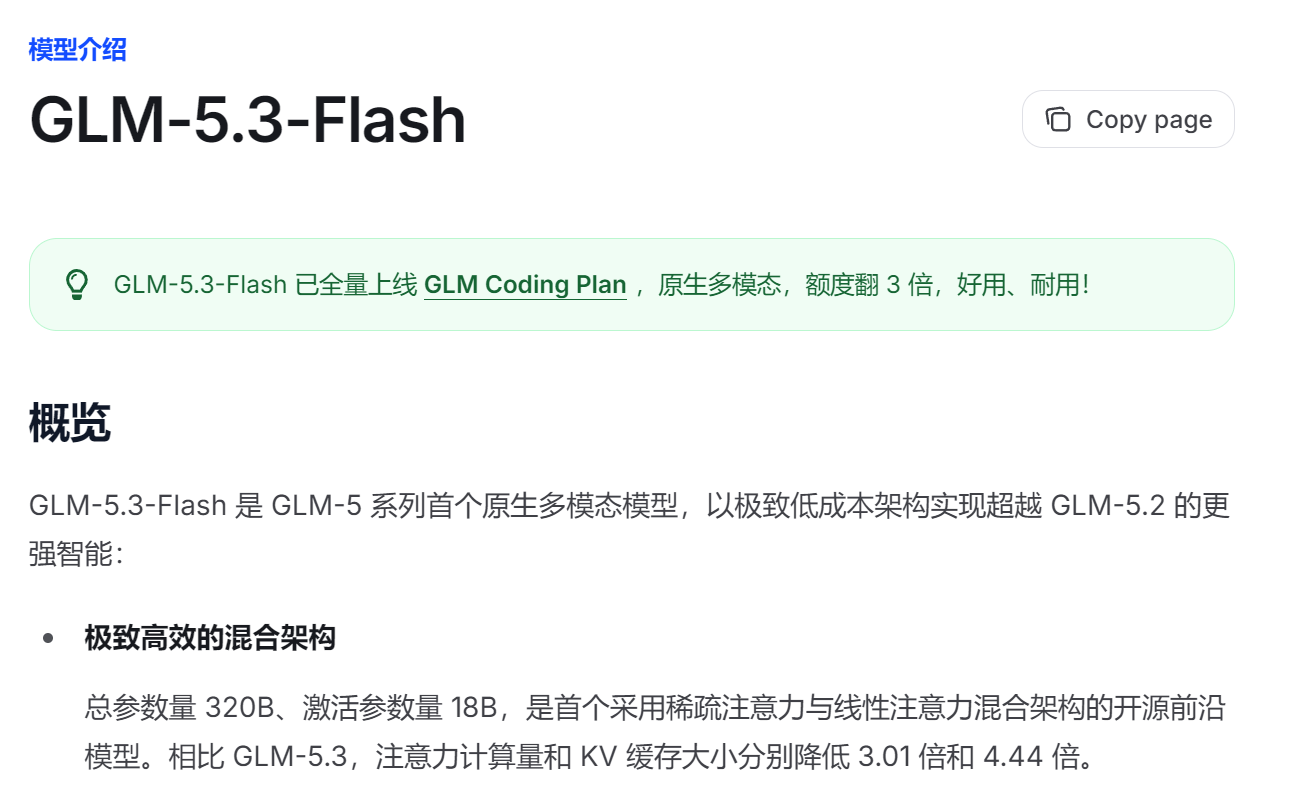
GLM-5.3-Flash 总参数约 320B,实际激活参数约 18B,支持百万级上下文,并且是 GLM-5 系列首个原生多模态模型,可处理文本、图片和视频。模型权重采用 MIT License 开放。
一、它到底强在哪里?
智谱公布的测试数据相当激进。
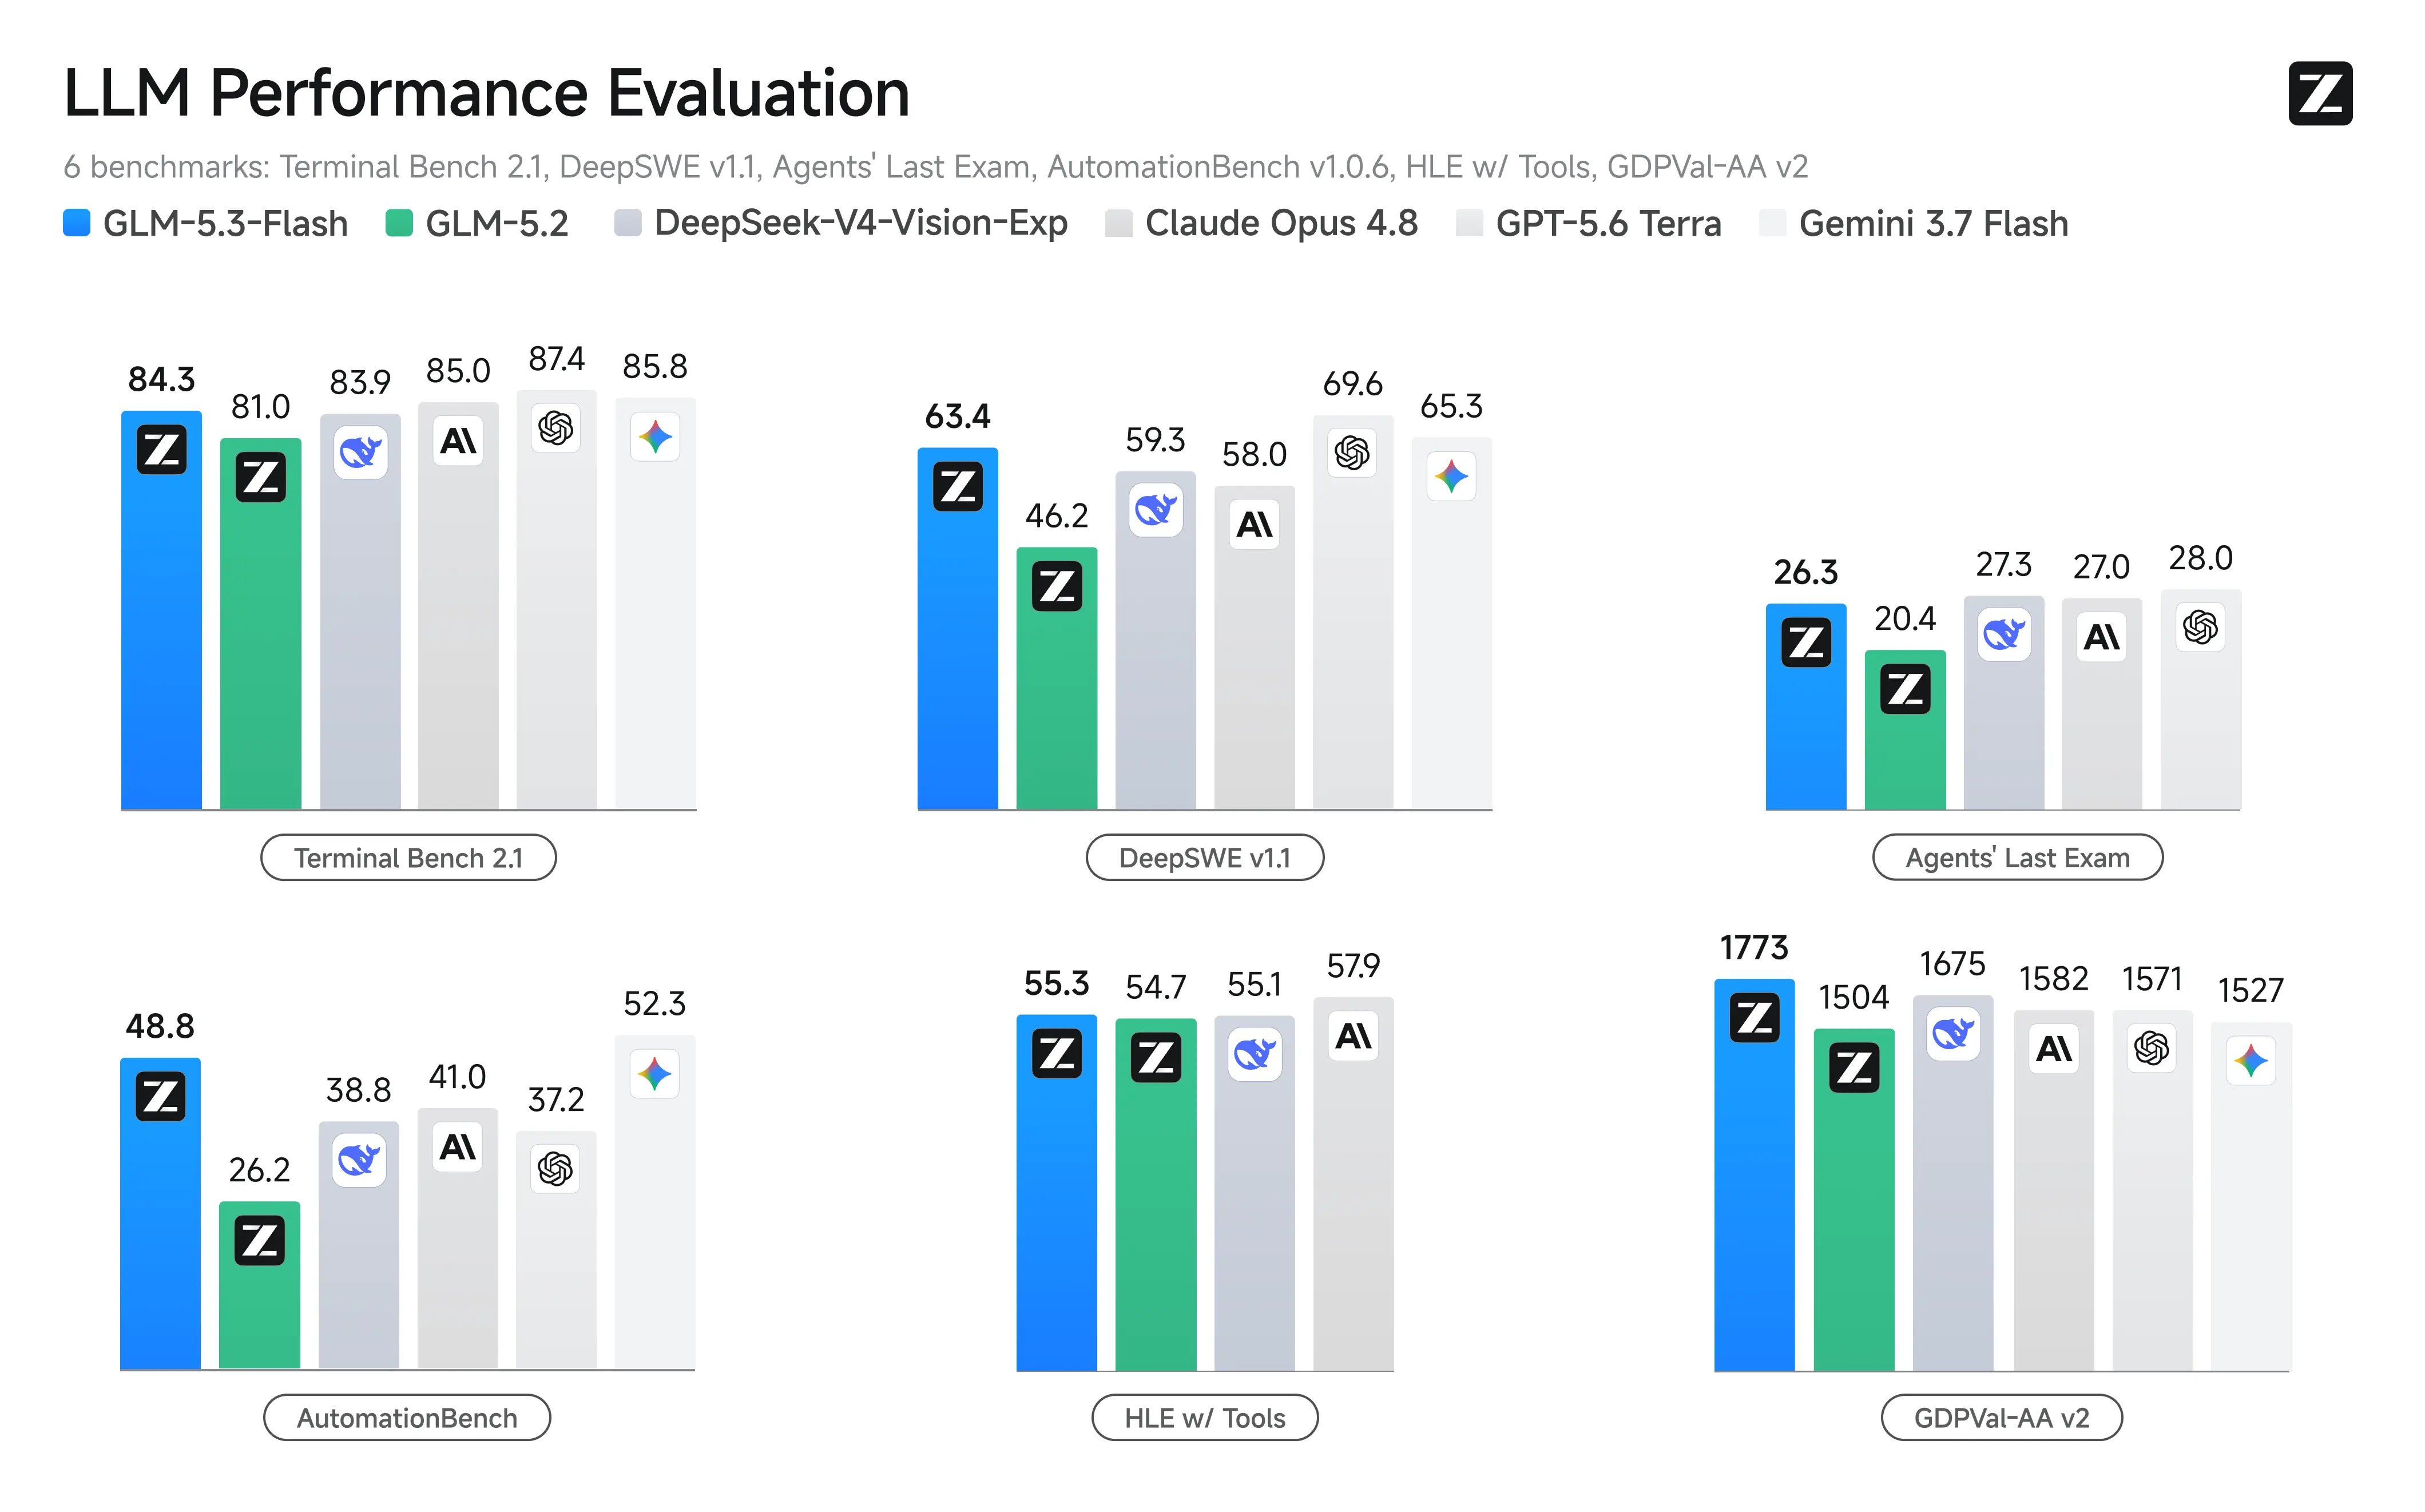
在 Terminal-Bench 2.1 中,GLM-5.3-Flash 达到 84.3,接近 Claude Opus 4.8 的 85.0;在 DeepSWE v1.1 中达到 63.4,明显高于 GLM-5.2 的 46.2;AutomationBench 则从上一代的 26.2 提升至 48.8。
其中尤其值得注意的是 DeepSWE——这是面向长期软件工程任务的测试。换句话说,GLM-5.3-Flash 并不是单纯擅长“写几段代码”,而是开始针对 Coding Agent、工具调用和长任务执行进行优化。
不过,这里需要给这些数字加一个注释:
这些成绩中有相当一部分来自智谱自己的测试,不能简单等同于独立实验室结论。
真正有参考价值的,是第三方统一测试。
Artificial Analysis 目前给 GLM-5.3-Flash 的 Intelligence Index 为 57,明显高于同规模开放权重模型约 27 的中位水平。其测试中的输出速度约 50.2 tokens/s,首 Token 延迟约 1.47 秒。
因此,一个比较稳妥的评价是:
GLM-5.3-Flash 已经进入前沿级开源模型的竞争区间,但“全面超过所有旗舰模型”仍然不是一个严谨的结论。
二、真正有意思的对手:DeepSeek
如果只看模型能力,GLM-5.3-Flash 的意义可能还没有那么大。
真正让它变得有意思的是:
它开始直接挑战 DeepSeek 在“高性价比大模型”领域的位置。
目前比较合适的对象是 DeepSeek-V4-Flash 和 V4-Pro。
| 指标 | GLM-5.3-Flash | DeepSeek V4 Flash | DeepSeek V4 Pro |
| Artificial Analysis Intelligence | 57 | 52 | 53 |
| 输出速度 | 50.2 tok/s | 119.4 tok/s | 约67 tok/s |
| 上下文 | 1M | 1M | 1M |
| 原生视觉 | 支持 | 需使用 Vision 实验版本 | 当前主模型不支持 |
| 开源权重 | MIT | MIT | MIT |
以上能力、速度和价格数据来自 Artificial Analysis 的统一比较;DeepSeek 官方也确认 V4 Flash/Pro 均支持 1M 上下文以及工具调用。
从能力指数来看,GLM-5.3-Flash 暂时领先 DeepSeek V4 系列。
但如果换一个指标,结果马上发生变化。
DeepSeek V4 Flash 的输出速度约为 GLM-5.3-Flash 的 2.4 倍。
所以“Flash”并不意味着 GLM 一定是更快的那个。
它更准确的含义是:
用更低的成本提供尽可能高的模型能力。
三、价格:GLM-5.3-Flash 真正的杀手锏
GLM-5.3-Flash 的官方 API 标准价格为:
- 输入:$0.15 / 100万 tokens
- 缓存输入:$0.03 / 100万 tokens
- 输出:$0.50 / 100万 tokens
目前还有临时 5 折优惠,优惠价为 $0.075 / $0.25,但该优惠预计在 2026年9月9日结束,因此长期成本应该按照标准价格计算。
DeepSeek V4 Flash 的官方价格则为:
- 缓存命中输入:$0.007~0.014
- 普通输入:$0.22~0.44
- 输出:$0.66~1.32
具体价格根据高峰/非高峰时段变化。
这里容易产生一个误解:
不能只看“输入价格”。
因为实际 AI Agent 往往会产生大量输出 Token。
Artificial Analysis 按统一的缓存/输入/输出比例计算后,GLM-5.3-Flash 的混合成本约 $0.10 / 百万 tokens,DeepSeek V4 Flash 约 $0.23。
这也是 GLM-5.3-Flash 最有杀伤力的地方:
它并没有单纯追求“最便宜”,而是试图把“能力/价格”做到极高。
四、那到底应该选 GLM 还是 DeepSeek?
如果只是普通聊天,其实两者都已经足够强。
但如果按照使用场景区分,答案会更加清晰。
选择 GLM-5.3-Flash
比较适合:
- Coding Agent
- 长上下文任务
- 图片理解
- UI / 网页截图分析
- 文档分析
- 多模态 Agent
- 大量 API 调用
- 希望使用开放权重模型
尤其是代码 + 图片 + Agent混合任务,是 GLM-5.3-Flash 比较有特色的地方。
选择 DeepSeek V4 Flash
更加适合:
- 大量高速文本生成
- 高并发 API
- 对响应速度敏感的应用
- 纯文本 Agent
- 已经基于 DeepSeek API 开发的应用
DeepSeek V4 Flash 的输出速度优势非常明显。
选择 DeepSeek V4 Pro
如果更看重复杂 Agent 工作流,也可以考虑 V4 Pro。
DeepSeek 官方公布的 V4 Pro 数据中,Terminal-Bench 2.1 为 87.9,DeepSWE 为 62.7,Toolathlon-Verified 为 74.1,同时支持 low / high / max 三档思考强度。
五、GLM-5.3-Flash 最大的意义
GLM-5.3-Flash 最值得关注的地方,其实不是“它有没有超过 DeepSeek”。
而是:
前沿模型正在快速进入白菜价时代。
过去一个复杂 Agent 任务可能需要调用昂贵的旗舰模型。
现在,一个开发者可以用非常低的成本,让模型:
读取项目 ↓ 理解代码 ↓ 修改代码 ↓ 运行测试 ↓ 查看截图 ↓ 继续修改
而且这一整个过程都可以重复几十甚至几百次。
这对于个人开发者、小型网站和独立开发者尤其重要。
六、结论:DeepSeek 仍然很强,但已经不再“独占性价比”
如果用一句话评价 GLM-5.3-Flash:
它不是一个简单的“DeepSeek 替代品”,而是把国产开源大模型的竞争进一步推向了“能力 × 速度 × 多模态 × 价格”的综合战争。
DeepSeek V4 Flash 依然拥有非常明显的速度优势;V4 Pro 在复杂 Agent 任务上也具有竞争力。
但 GLM-5.3-Flash 的出现意味着:
现在选择大模型,已经不能只问“谁最强”,而应该问“谁最适合我的任务”。
对于个人开发者来说,如果需要便宜、强大的 Coding Agent,同时又希望模型能够直接理解图片和界面,GLM-5.3-Flash 已经成为非常值得尝试的选择。
而对于闲报这样的独立网站来说,它更值得关注的地方可能是另一件事:
当一个接近前沿水平的模型已经便宜到个人开发者可以随意调用时,AI 应用真正的门槛正在从“模型有多贵”转向“你到底能用它做什么”。
这可能才是 GLM-5.3-Flash 比某一个具体跑分更值得关注的地方。
数据说明:本文中的模型能力指数、速度等统一测试数据主要参考 Artificial Analysis;模型厂商公布的 Terminal-Bench、DeepSWE 等成绩均标注为厂商测试,不应与第三方测试直接混为一谈。价格以公开资料截至 2026 年 9 月 7 日为准,促销价格可能变化。


评论区 (0)
还没有评论,来发表第一条吧